Моделі на ваших даних, які прогнозують, сортують і помічають відхилення.
Машинне навчання (ML) потрібне там, де задачу не описати простими правилами: скільки товару замовити на сезон, до якого відділу віднести лист, що написано в накладній. Ми перевіряємо ваші дані, будуємо модель, вбудовуємо її в робочі системи й стежимо за її точністю.
Що таке ML-інжиніринг простими словами
Звичайна програма виконує правила, які хтось записав: якщо сума замовлення більша за певну, доставка безкоштовна. Але є задачі, де правил забагато або їх неможливо сформулювати. Скільки цементу продасться в березні? Цей лист про повернення чи про доставку? У таких задачах модель вчиться на прикладах із ваших даних.
ML-інжиніринг означає не лише навчити модель, а й зробити так, щоб вона працювала щодня: отримувала свіжі дані, віддавала результат у CRM чи таблицю, а ви бачили, наскільки вона точна.
Задачі, з якими ми працюємо
Найчастіше машинне навчання корисне в п’яти типах задач:
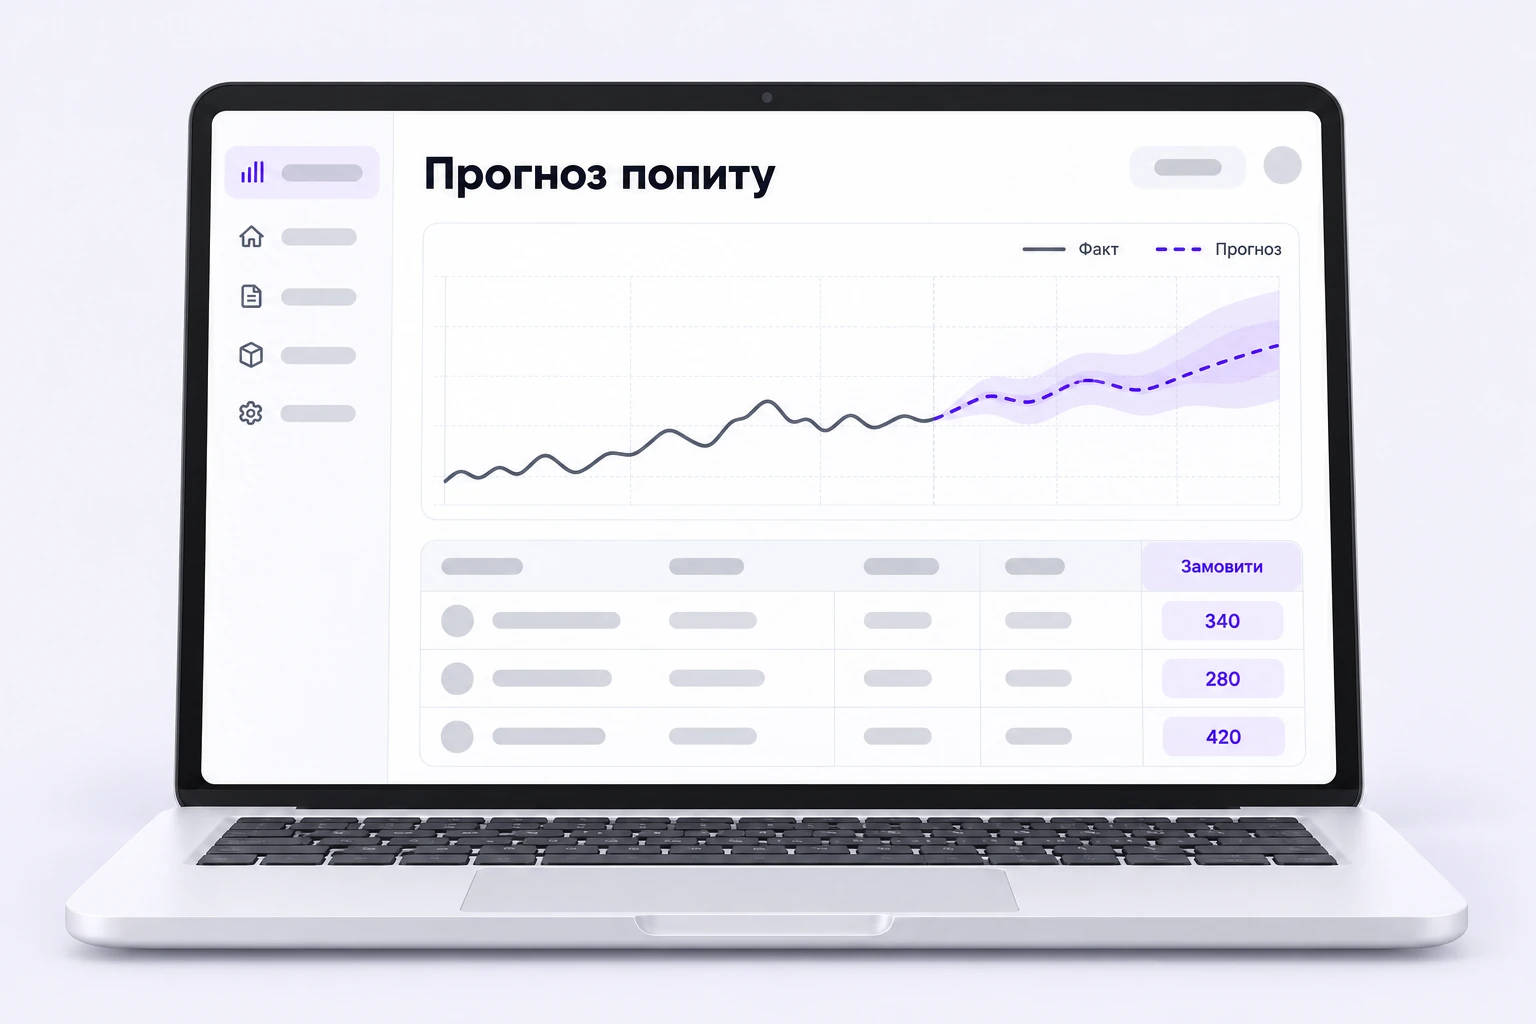
- Прогноз попиту. Приклад: скільки цементу й щебеню замовити на кожен склад перед сезоном, щоб не заморожувати гроші в залишках і не втрачати продажі через дефіцит.
- Класифікація звернень. Лист, повідомлення в Telegram чи Viber або заявка з сайту одразу отримує тему й терміновість і потрапляє до потрібного відділу.
- Розпізнавання документів. Дані з рахунків, актів і накладних «Нової пошти» потрапляють у таблицю чи облікову систему без ручного набору.
- Рекомендації. Інтернет-магазин пропонує покупцеві те, що справді доповнює кошик, а менеджер бачить, кому з клієнтів що запропонувати.
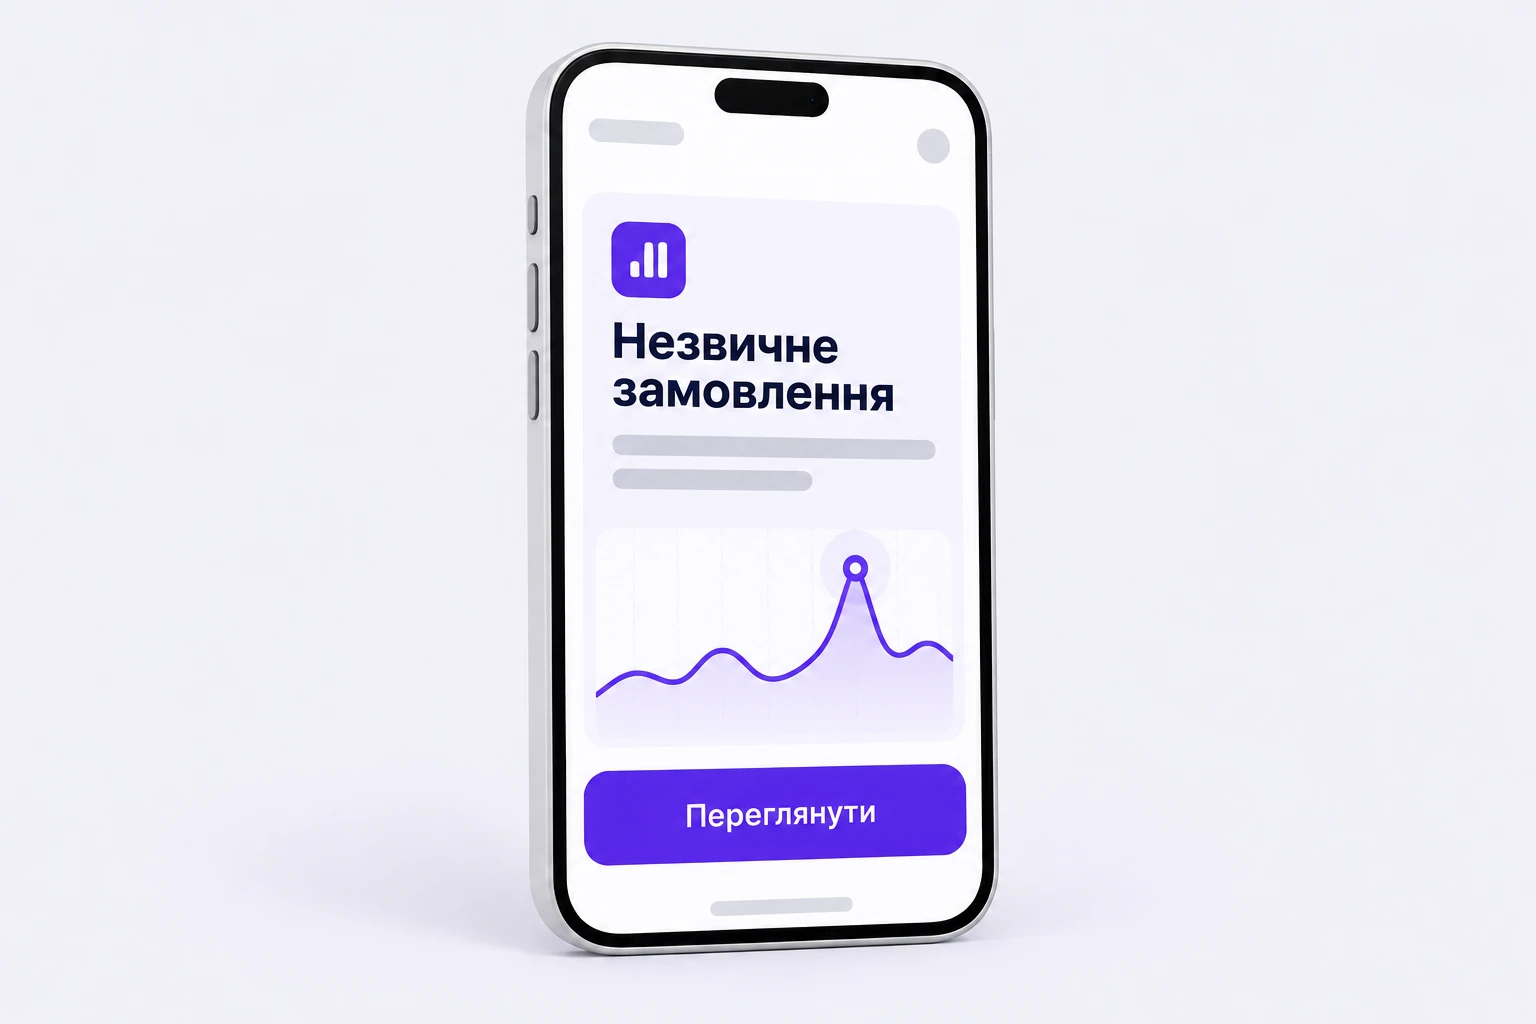
- Пошук аномалій. Подвійні оплати, підозрілі повернення, незвичні знижки чи показники обладнання, на які варто глянути людині, поки вони не стали проблемою.
Що ми перевіряємо першим
Перш ніж говорити про модель, ставимо кілька питань до даних:
- Чи є історія продажів хоча б за два сезони?
- Де лежать дані: CRM, облікова система, таблиці чи вивантаження з Prom.ua?
- Як задачу розв’язують зараз і наскільки точно?
- Куди має потрапляти результат: у таблицю закупівель, CRM чи Telegram?
- Хто ухвалюватиме рішення, коли модель не впевнена?
Як ми будуємо модель
Модель настільки добра, наскільки добрі дані, тому починаємо з них, а не з алгоритму.
- Аудит даних. Перевіряємо повноту, помилки й дублікати і чесно кажемо, чи даних достатньо. Буває й такий висновок: даних поки замало, ось що варто почати збирати.
- Проста основа для порівняння. Записуємо, як задачу розв’язують зараз, і рахуємо найпростіший варіант: правило чи середнє за минулі сезони. Модель має сенс, лише якщо вона помітно краща за нього.
- Перевірка на історії. Навчаємо модель на минулих даних і перевіряємо на періоді, якого вона не бачила. Якщо вона не краща за просту основу, зупиняємося ще до інтеграції.
- Вбудовування. Прогноз потрапляє в таблицю закупівель, тема звернення в CRM, дані накладної в облік.
- Нагляд. Стежимо за точністю на свіжих даних і перенавчаємо модель, коли змінюються сезон, асортимент чи ціни.
Що відбувається після запуску
Модель старіє. Змінюються ціни, постачальники й поведінка клієнтів, і прогноз, точний навесні, восени може помилятися. Тому ми розгортаємо модель як частину системи, а не як файл на чиємусь комп’ютері.
Кожна версія моделі має опис: на яких даних її навчено, як перевірено і наскільки вона точна. Нову версію запускаємо так само обережно, як оновлення сайту, з можливістю повернутися до попередньої. Моніторинг показує точність і те, чи не змінилися вхідні дані (дрейф даних), а випадки, у яких модель не впевнена, передає людині.
Як це виглядає
Приклади інтерфейсів, які ми будуємо. Дані на екранах вигадані.
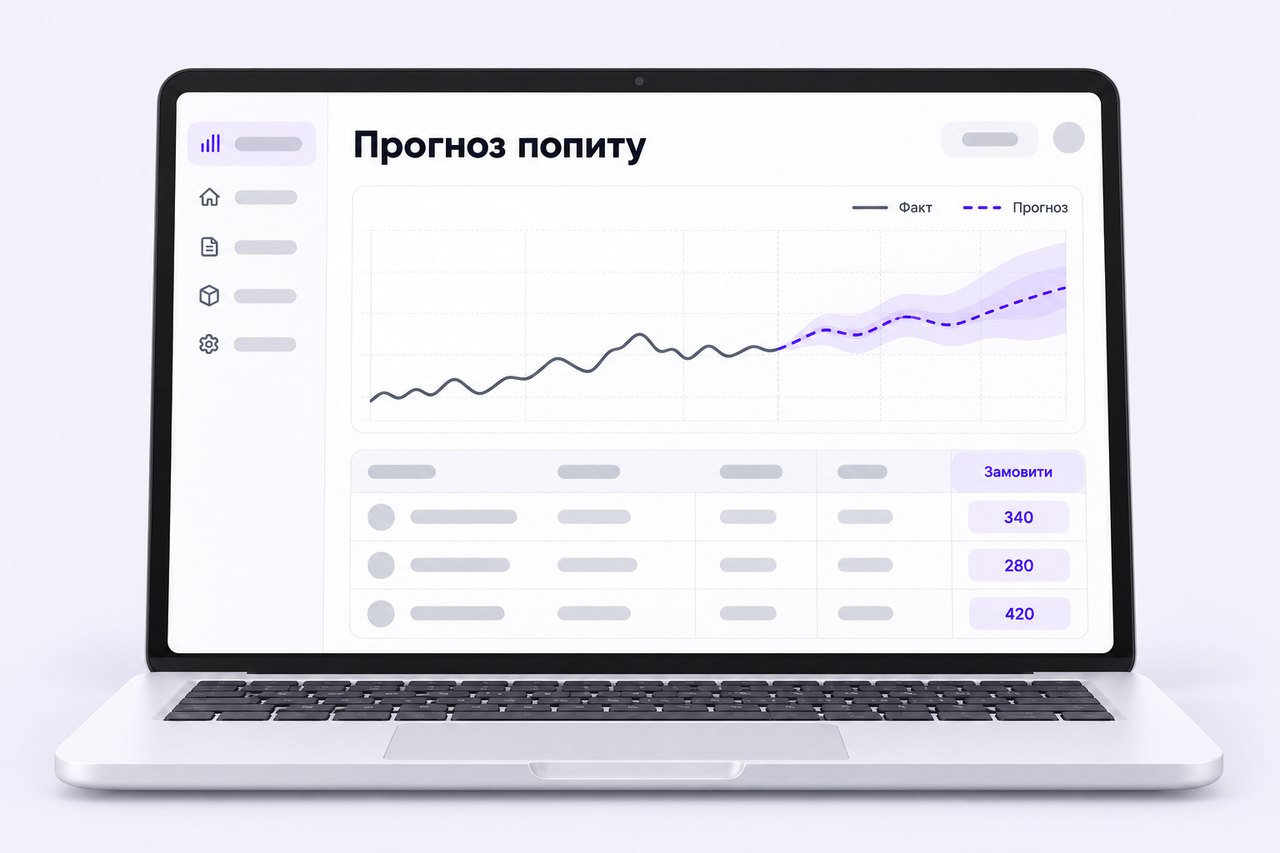
Прогноз попиту поруч із фактом і скільки замовити
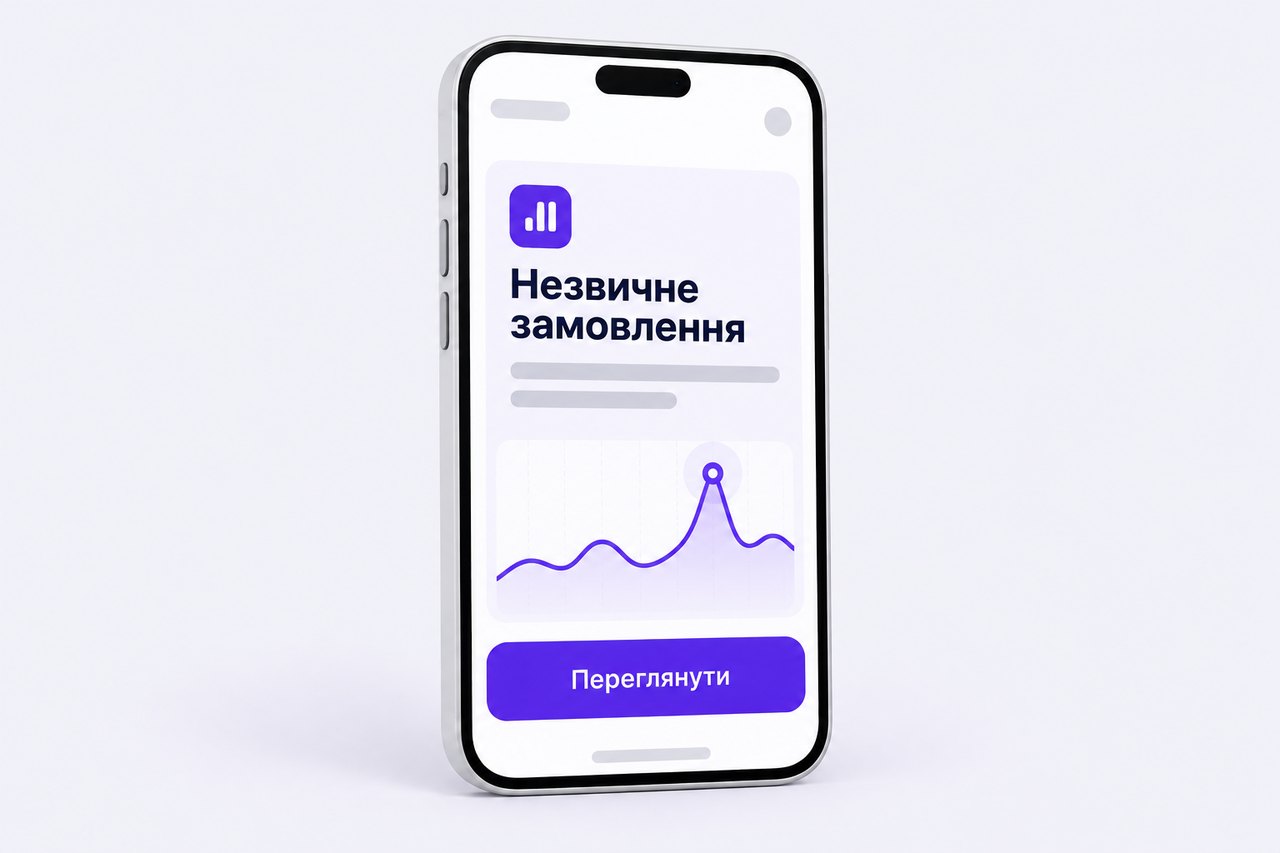
Сповіщення про незвичне замовлення
Коли ML не потрібен
Якщо задачу розв’язує правило чи звіт у Google Sheets, модель не потрібна. Приклад: щоб бачити, який товар закінчується, достатньо звіту із залишками й мінімальним запасом. Модель потрібна, коли треба передбачити, скільки продасться, а не порахувати, скільки лишилося.
Модель не допоможе й тоді, коли даних поки немає: новий асортимент чи бізнес без історії продажів. Ми скажемо про це на першій розмові й підкажемо, які дані почати збирати.
Дані й розміщення моделі
До старту домовляємося, які дані потрібні для задачі, де вони зберігаються і хто має до них доступ. Модель розміщуємо на наших серверах у ЄС і беремо на себе сервер, оновлення, моніторинг і резервні копії, а за вашим вибором розгортаємо її на вашому сервері. Персональні дані обробляємо за вимогами GDPR, а де можливо, знеособлюємо ще до навчання моделі.
Що ви отримуєте
Кожен етап закінчується результатом, який можна перевірити:
- Звіт про ваші дані: що є, якої якості і чого бракує для задачі.
- Порівняння моделі з простою основою на періоді, якого модель не бачила.
- Модель, вбудовану в робочий процес, а не окремий експеримент.
- Опис кожної версії моделі: дані, спосіб перевірки, точність.
- Код навчання й опис моделі разом із документацією, з якою модель зможе супроводжувати інша команда.
Питання
Питання про ML-інжиніринг.
Скільки даних потрібно, щоб почати?
Залежить від задачі. Для прогнозу попиту потрібна історія продажів, яка охоплює сезонні коливання, для розбору звернень вистачить прикладів кожної теми. Аудит даних покаже, чи їх достатньо і що варто почати збирати вже зараз.
Чим ML-модель відрізняється від ChatGPT?
Мовні моделі на кшталт ChatGPT добре працюють із текстом і розмовою. Власна модель вчиться на ваших цифрах і прикладах: продажах, зверненнях, документах. Часто найкращий результат дає поєднання: мовна модель читає лист клієнта, а ваша модель прогнозує, скільки товару знадобиться.
Що, якщо модель помилятиметься?
Помиляється будь-яка модель, тому до запуску вимірюємо, як часто і в яких випадках. Для невпевнених випадків ставимо поріг, після якого рішення ухвалює людина, а після запуску стежимо, чи не зростає кількість помилок.
Де працюватиме модель і хто бачитиме дані?
На наших серверах у ЄС, де сервер, оновлення, моніторинг і резервні копії ми беремо на себе, або на вашому сервері, якщо вам так зручніше. Доступ до даних отримують лише ті, кому він потрібен для задачі, і цей список ми погоджуємо до старту.
Що лишається у вас після проєкту?
Код навчання й опис моделі передаємо разом із документацією, з якою модель зможе супроводжувати інша команда. Що й на кого оформлюється, фіксуємо в договорі.
Чи можна почати без великого проєкту?
Так. Перевірка на ваших історичних даних покаже, чи модель краща за нинішній спосіб, ще до будь-якої інтеграції. Якщо ні, ви дізнаєтеся це на невеликому обсязі робіт, а не після впровадження.
Поговорімо
Розкажіть, які дані у вас уже є.
Продажі, звернення, документи чи показники обладнання. Підкажемо, яку задачу на них можна розв’язати і з чого почати.